同款识别(一):类目与属性基线
本文是《电商同款识别:从属性标准化到可迭代的商品理解系统》的第一篇。文中案例、字段和值均为合成示例。
同款识别常被误解为“找标题相似的商品”。从技术上看,它首先是一个商品理解问题:两个商品的标题可能完全不同,却表示同一种商品;标题很像的商品,也可能只差一个足以改变商品身份的规格。
这一阶段的目标不是一次解决所有长尾表达,而是建立一套可解释的比较基线:在给定类目下,明确哪些属性定义同款,哪些属性只是展示差异。
1. 问题从哪里开始
1.1 “相似”不等于“同款”
在公开的商品标题里,品牌、营销词、规格、套装数量和颜色常被混合书写;重要信息也可能散落在标题、规格选项和详情描述中。因此,字符串相似度只能作为一个很弱的候选信号。
一个合成例子:
| 商品 | 标题 | 关键差异 |
|---|---|---|
| A | 旅行保温杯 500ml 黑色 |
容量 500ml |
| B | 大容量随行杯 黑 0.5L |
容量 500ml,与 A 可比较 |
| C | 旅行保温杯 750ml 黑色 |
容量不同,不应与 A 直接聚合 |
这里,“颜色”是否影响聚合取决于下游目标;“容量”则可能是决定可比性的关键规格。识别系统的第一项工作,是把这种判断显式化。
1.2 类目树不必每条路径都一样深
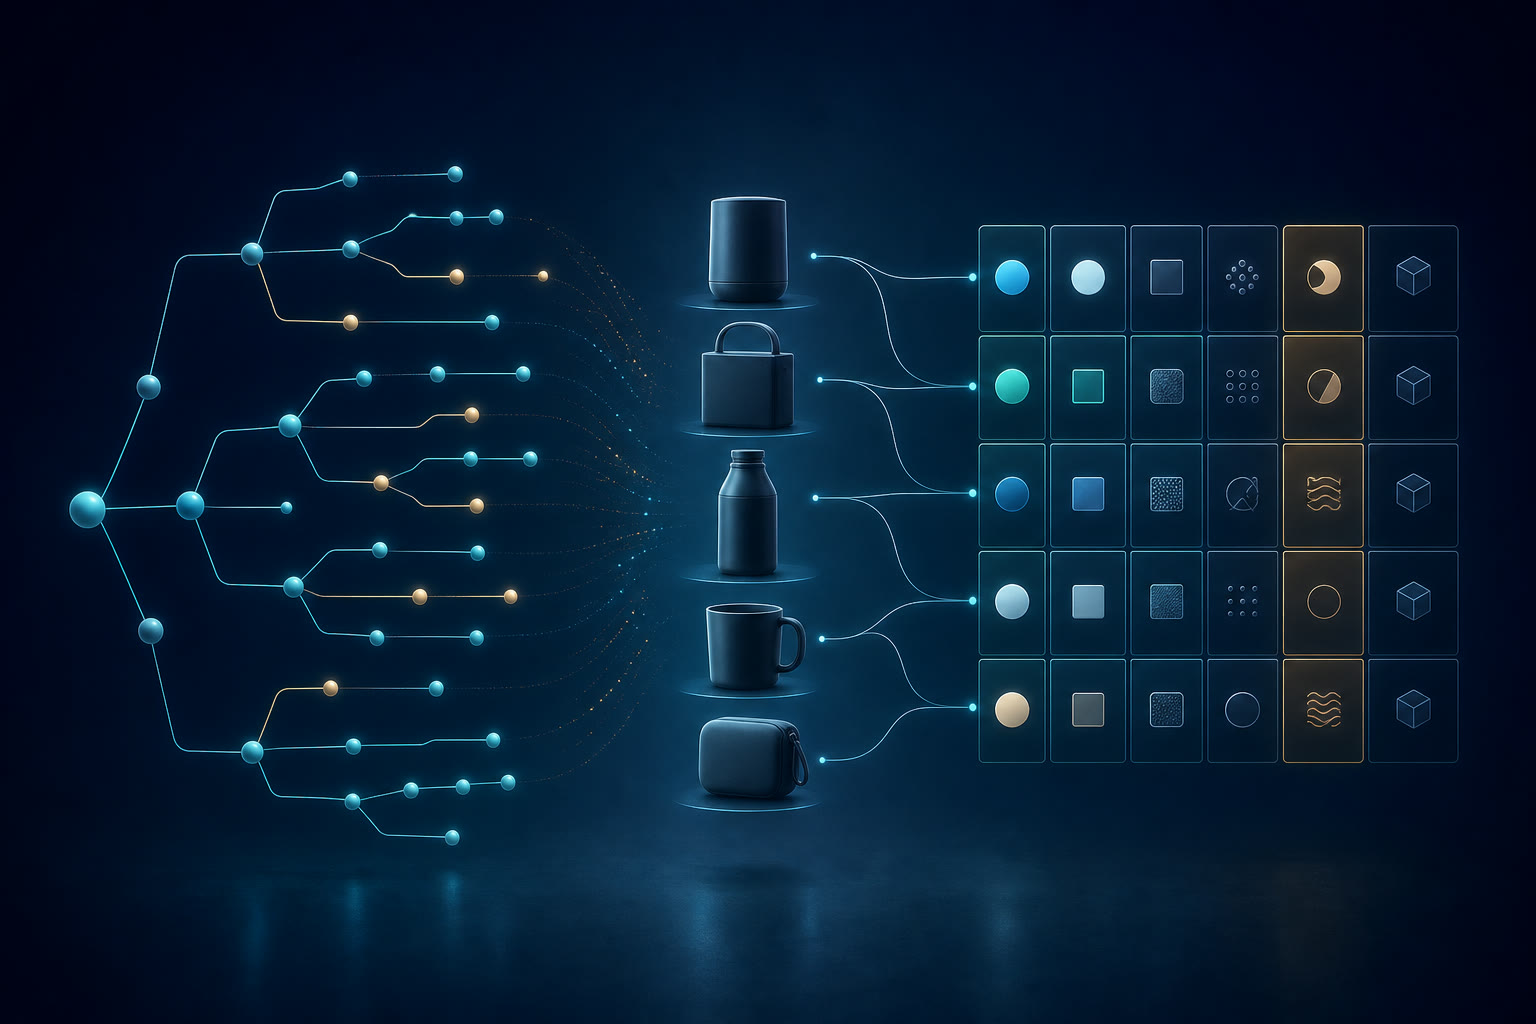
第一阶段的基础,是一套层级类目体系。它最多可以展开到五级,但“五级”只是最大深度,并不是每个商品都必须被机械地划到第五层。
类目树的深度取决于当前节点里的商品是否已经足够同质:有些品类到第三级时,商品的功能和属性结构已经比较稳定,可以直接作为叶子类目;另一些品类内部差异仍然很大,就需要继续拆到第四级或第五级。换句话说,我们关心的不是层级数量本身,而是叶子节点能否形成一个边界清晰、可以共享同一套比较规则的商品集合。
这种设计避免了两个极端:类目过粗时,不同类型的商品会被迫使用同一套属性;类目过细时,类目体系又会变得难以维护,甚至在真正开始同款判断前就把商品切得过碎。
1.3 为每个叶子类目建立 definition
类目树确定后,需要为每个叶子类目定义一份属性规范。这里的 definition 不是一句自然语言描述,而是一组能够覆盖并区分该叶子类目商品的属性集合。
例如,“认知卡片”可以由品牌、材质、尺寸、卡片数量、卡片类型、语言和销售数量等属性共同描述;同属教育玩具的“教育海报”,则更适合由品牌、材质、尺寸、海报类型、适用年龄、语言和销售数量来描述。两者很接近,却不能简单复用完全相同的属性表。
在第一阶段,我们暂不进一步区分属性类型,而是把 definition 中列出的属性共同作为该叶子类目的描述维度。例如,品牌回答“它是谁生产的”,材质和尺寸回答“它是什么形态”,卡片数量、卡片类型和语言则进一步刻画具体的商品内容与销售规格。
这些属性联合起来,相当于为叶子类目定义了一组“坐标轴”:每件商品都被映射成一个结构化属性向量,同款判断也就从模糊的文本相似问题,变成了同一坐标系中的精确比较问题。
1 | 商品文本与选项 |
2. 建立可解释的属性基线
2.1 用属性联合匹配定义同款
第一阶段可以采用一条直接且可解释的规则:两个商品必须先落在同一个叶子类目中,再比较该类目 definition 中的全部属性;只有参与判断的属性值都一致,才将它们判为同款。
设叶子类目 的属性集合为 ,商品 在属性 上经过标准化后的值为 ,那么这条规则可以写成:
这个公式的重要之处不在于复杂,而在于明确了同款判断的边界:类目不同,不进入比较;任何一个定义属性不同,都不判为同款;只有整组属性一致,才形成同款关系。
为了让比较成立,原始属性值还需要先做标准化。例如 0.5 L 与 500 ml 应归一到同一容量,50 sheets 与 50 cards 是否等价则必须由类目定义决定。否则,规则比较的只是字符串,而不是商品语义。
对于没有抽取到值的属性,可以统一使用 None 填充。这样每件商品都能生成长度一致的属性向量,后续可以直接逐字段比较,而不需要为每一种缺失情况设计不同的数据结构。
2.2 用 NER 与规则构造属性向量
在非大模型方案中,可以从商品标题、规格选项和详情描述等文本中读取信息,再通过 NER 与规则抽取 definition 要求的属性。
NER 负责从非结构化文本中定位品牌、材质、尺寸、数量等候选实体;规则则承担更确定的解析与归一工作,例如识别数值和单位、映射别名、处理固定格式,以及将抽取结果写入对应的属性槽位。两者结合后,每件商品都会得到一条与叶子类目 definition 对齐的属性向量。
1 | 标题 / 规格选项 / 详情描述 |
1 | { |
上例中,材质没有从任何文本字段中识别出来,因此在比较前会被统一填充为 None。
2.3 示例一:标题不同,但属性完全一致
假设“认知卡片”叶子类目的 definition 包含以下属性:品牌、材质、尺寸、卡片数量、卡片类型、语言和销售数量。
| 属性 | 商品 A | 商品 B |
|---|---|---|
| 标题 | 儿童启蒙字母闪卡 50 张 | 早教英文字母学习卡片套装 |
| 品牌 | BrightKids | BrightKids |
| 材质 | 纸质 | 纸质 |
| 尺寸 | 10 × 15 cm | 100 × 150 mm |
| 卡片数量 | 50 | 50 |
| 卡片类型 | 字母卡 | 字母卡 |
| 语言 | 英语 | English |
| 销售数量 | 1 套 | 1 set |
两条标题的字面差异较大,但经过单位、语言和枚举值归一后,definition 中的属性全部一致,因此可以判定为同款。这说明结构化属性能够穿过营销词和表达方式的差异。
2.4 示例二:标题很像,但一个属性不同
再看商品 C:
| 属性 | 商品 A | 商品 C |
|---|---|---|
| 标题 | 儿童启蒙字母闪卡 50 张 | 儿童启蒙字母闪卡 80 张 |
| 品牌 | BrightKids | BrightKids |
| 材质 | 纸质 | 纸质 |
| 尺寸 | 10 × 15 cm | 10 × 15 cm |
| 卡片数量 | 50 | 80 |
| 卡片类型 | 字母卡 | 字母卡 |
| 语言 | 英语 | 英语 |
| 销售数量 | 1 套 | 1 套 |
两条标题高度相似,但卡片数量不同。因为“卡片数量”属于这个叶子类目的 definition,商品 C 不会与商品 A 判为同款。这个例子体现了 Stage 1 追求的不是宽泛相似,而是可解释、可核验的属性一致性。
2.5 definition 也决定哪些差异可以忽略
并不是商品页面上出现的所有字段都参与同款判断。如果某个展示字段没有进入该叶子类目的 definition,它的变化就不会改变判断结果。例如,在普通日用品中,包装图案可能只是展示差异;而在收藏品中,图案本身又可能是决定商品身份的核心属性。
所以,“全属性匹配”并不是比较页面上的所有信息,而是比较该叶子类目 definition 明确纳入的全部属性。这套边界需要结合任务定义和类目知识确定。
3. 规则基线暴露出的难题
当属性定义和全匹配基线跑通后,问题会变得具体:
- 同一概念有多种表达,规则难以穷举;
- 信息分散在多个字段,需要跨字段关联;
- 商品信息缺失、冲突或填写不规范;
- 不同语言和类目的表达差异,让固定词表迅速膨胀。
此外,严格的全属性匹配对属性质量非常敏感:一个属性抽错会造成误拆分,一个单位未归一也可能让真实同款无法合并。
统一使用 None 填充缺失属性简化了工程实现,但也引入了一个清晰的风险:当两个商品在同一个属性上都没有抽取到值时,None == None 会被视为匹配。缺失属性较少时,这种做法可以减少因单个空值造成的漏判;当多个重要属性同时缺失时,两件信息不完整的商品却可能因为共享大量 None 而被误判为同款。因此,这套方案高度依赖 NER 与规则的属性覆盖率。
类目本身也形成了一层天然边界。如果真实同款被分到了两个相邻叶子类目,那么属性规则再准确,它们也没有机会进入同一次比较。这既是第一阶段的可解释性来源,也是后续提升召回时必须解决的限制。
这些问题并不意味着规则没有价值。相反,Stage 1 完成了最重要的问题建模:用类目控制比较范围,用 definition 明确商品身份,再用属性一致性提供可解释的判断依据。后续无论引入语义向量还是大模型属性抽取,都可以继续复用这套表示和判断边界。
4. 从 Stage 1 带走什么
同款识别的第一步不是训练一个更大的相似度模型,而是回答三个问题:
- 在这个类目里,什么差异会改变商品的可比性?
- 这些信息分别出现在哪些字段,冲突时信任谁?
- 当信息缺失或不可靠时,系统应该保守拒绝,还是进入候选召回?
下一篇将讨论:当规则无法覆盖长尾表达时,如何利用文本和图文 Embedding 扩展候选召回,同时避免“语义相近”被误判成“同款”。
继续阅读: 同款识别(二):双路召回与聚类